Domain zufallsvariable.de kaufen?
Wir ziehen mit dem Projekt
zufallsvariable.de um.
Sind Sie am Kauf der Domain
zufallsvariable.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain zufallsvariable.de kaufen?
Wann Korrelation und wann Regression?
Wann Korrelation und wann Regression? Korrelation wird verwendet, um den Grad des Zusammenhangs zwischen zwei Variablen zu messen, ohne eine Ursache-Wirkungs-Beziehung zu postulieren. Wenn man herausfinden möchte, ob und wie stark zwei Variablen miteinander zusammenhängen, ist die Korrelation die geeignete Methode. Regression hingegen wird verwendet, um eine Vorhersage oder Schätzung einer abhängigen Variablen basierend auf einer oder mehreren unabhängigen Variablen zu machen. Wenn man also den Einfluss einer oder mehrerer Variablen auf eine andere Variable untersuchen möchte, ist die Regression die passende Methode. Insgesamt kann man sagen, dass Korrelation verwendet wird, um den Zusammenhang zwischen Variablen zu untersuchen, während Regression verwendet wird, um Vorhersagen oder Schätzungen basierend auf diesen Zusammenhängen zu machen. Beide Methoden sind wichtige Werkzeuge in der statistischen Analyse, jedoch mit unterschiedlichen Anwendungsgebieten und Zielen. **
In welchen Bereichen der Psychologie, Soziologie und Statistik wird der Begriff "Signifikanz" verwendet und wie wird er definiert?
In der Psychologie wird der Begriff "Signifikanz" verwendet, um zu beurteilen, ob die Ergebnisse einer Studie aufgrund von Zufall oder tatsächlichen Effekten beruhen. In der Soziologie wird Signifikanz verwendet, um zu bestimmen, ob die Beziehungen zwischen Variablen in einer Studie statistisch bedeutsam sind. In der Statistik wird Signifikanz verwendet, um festzustellen, ob ein beobachteter Effekt größer ist als das, was aufgrund von Zufall zu erwarten wäre. Signifikanz wird definiert als die Wahrscheinlichkeit, dass ein beobachteter Effekt auf Zufall beruht, und wird in der Regel durch einen p-Wert ausgedrückt. **
Ähnliche Suchbegriffe für Definiert
Top-Angebote
Produkte zum Begriff Definiert:
-
Die Qumran-Essener-Hypothese, Fachbücher von Roland BergmeierDas Buch "Die Qumran-Essener-Hypothese" von Roland Bergmeier bietet eine umfassende Analyse der Hypothese, dass die Essener sowohl die Bewohner der Qumrananlage als auch die ursprünglichen Besitzer der Schriftrollen vom Toten Meer waren. Diese Hypothese, die von Historikern wie Philo, Josephus und Plinius diskutiert wurde, wird in der aktuellen Forschung zunehmend hinterfragt. Bergmeier untersucht die archäologischen Befunde der Qumrananlage sowie die Schriftrollen und deren historische Kontexte. Durch eine kritische Neubewertung der bestehenden Literatur und der archäologischen Daten leistet das Buch einen wertvollen Beitrag zur Josephus-Forschung und zur Diskussion über die Essener. Es richtet sich an Wissenschaftler, Studierende und Interessierte der Geisteswissenschaften, insbesondere im Bereich Religion und Theologie.55,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Datenanalyse mit SPSS, Fachbücher von Michael StreichDieses Buch richtet sich an Studentinnen und Studenten, die im Rahmen ihrer Seminar-, Bachelor- oder Masterarbeit quantitative Daten erheben. Neben deskriptiven Analysen sind in solchen Situationen zumeist induktive statistische Verfahren gefordert, die auf den ersten Blick teilweise relativ komplex erscheinen. In diesem Buch werden typische Verfahren eingeordnet und inhaltlich erläutert. Neben einer einfachen Einführung werden im Nachgang vertiefende Analysen vorgestellt. Alle Verfahren werden anhand von Beispielen auf Basis der Statistiksoftware IBM SPSS dargestellt, die einen sehr einfachen Zugang auch zu komplexeren Verfahren bietet. Dabei werden die Beispiele, nach einer Einführung in das Programm als solches, systematisch Schritt für Schritt bearbeitet, so dass auch eigene Analysen im Rahmen schriftlicher Arbeiten problemlos nachvollzogen werden können.39,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
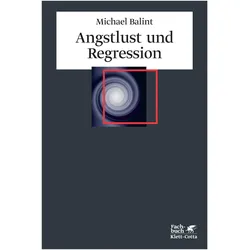
Angstlust und Regression, Fachbücher von Michael BalintAusgehend von Erlebnisqualitäten, die im Englischen mit "Thrill" bezeichnet werden, beschreibt Michael Balint zwei unterschiedliche Verhaltensweisen gegenüber der Welt: die "oknophile" und die "philobatische". Diese Unterscheidung hat zu interessanten Schlussfolgerungen im diagnostischen und therapeutischen Bereich geführt, im Blick auf die Objektbeziehungen, den Umgang mit Angst und Aggressivität, die Autoerotik, Liebe und Hass sowie die Fähigkeit zur Realitätsprüfung. Michael Balint, der durch seine Untersuchungen über die Arzt-Patient-Beziehung weithin bekannt geworden ist, legt hier eine neue psychologische Typenlehre vor. Er unterscheidet zwei Hauptverhaltensweisen gegenüber der Welt, die oknophile und die philobatische. Die erstere ist dadurch gekennzeichnet, dass der Mensch sich an seine Liebesobjekte anklammert und in dieser Anklammerung Schutz und Wonne des Gehaltenseins sucht.25,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was ist die Bedeutung und Anwendung von Korrelation in Statistik und Datenanalyse?
Die Korrelation misst den Zusammenhang zwischen zwei Variablen und zeigt, ob sie gemeinsam variieren. Sie wird verwendet, um Beziehungen zwischen Daten zu identifizieren und Muster zu erkennen. Korrelationen können positiv, negativ oder neutral sein und helfen bei der Interpretation von statistischen Ergebnissen. **
-
Was ist die Bedeutung und Anwendung von Korrelation in der Statistik und Datenanalyse?
Die Korrelation misst den Zusammenhang zwischen zwei Variablen und gibt an, wie stark sie miteinander in Beziehung stehen. In der Statistik wird die Korrelation verwendet, um zu untersuchen, ob es einen linearen Zusammenhang zwischen Variablen gibt. Sie wird auch genutzt, um Vorhersagen zu treffen und Muster in den Daten zu identifizieren. **
-
Was ist eine Zufallsvariable und wie wird sie in der Wahrscheinlichkeitstheorie definiert?
Eine Zufallsvariable ist eine mathematische Funktion, die jedem möglichen Ergebnis eines Zufallsexperiments eine reelle Zahl zuordnet. In der Wahrscheinlichkeitstheorie wird sie als eine Funktion definiert, die jedem Element des Ereignisraums eines Zufallsexperiments eine reelle Zahl zuordnet. Sie ermöglicht es, Wahrscheinlichkeiten für verschiedene Ereignisse zu berechnen und statistische Analysen durchzuführen. **
-
Was ist der Unterschied zwischen Korrelation und Regression?
Was ist der Unterschied zwischen Korrelation und Regression? Korrelation misst lediglich die Stärke und Richtung des Zusammenhangs zwischen zwei Variablen, während Regression versucht, eine mathematische Beziehung zwischen den Variablen zu modellieren. Korrelation gibt keinen Hinweis auf Ursache und Wirkung, während Regression manchmal verwendet wird, um Vorhersagen zu treffen. Korrelation wird oft mit dem Korrelationskoeffizienten gemessen, während Regression die Beziehung durch eine Regressionsgleichung beschreibt. Insgesamt kann man sagen, dass Korrelation den Zusammenhang zwischen Variablen beschreibt, während Regression versucht, diesen Zusammenhang zu modellieren und zu erklären. **
Wie wird die Wahrscheinlichkeitsdichte einer Zufallsvariable definiert und was sind ihre grundlegenden Eigenschaften?
Die Wahrscheinlichkeitsdichte einer Zufallsvariable wird als Funktion definiert, die die Wahrscheinlichkeit angibt, dass die Zufallsvariable einen bestimmten Wert annimmt. Sie muss nicht-negativ sein und die Fläche unter der Kurve muss 1 betragen. Die Wahrscheinlichkeitsdichte kann genutzt werden, um Wahrscheinlichkeiten von Ereignissen zu berechnen. **
Wie wird eine Zufallsvariable definiert und wie wird sie in der Wahrscheinlichkeitstheorie verwendet?
Eine Zufallsvariable ist eine mathematische Funktion, die jedem möglichen Ergebnis eines Zufallsexperiments einen numerischen Wert zuordnet. Sie wird in der Wahrscheinlichkeitstheorie verwendet, um die Wahrscheinlichkeiten verschiedener Ereignisse zu berechnen und statistische Analysen durchzuführen. Zufallsvariablen können diskret oder kontinuierlich sein und dienen als Grundlage für die Modellierung von Zufallsprozessen. **
Top-Angebote
Produkte zum Begriff Definiert:
-
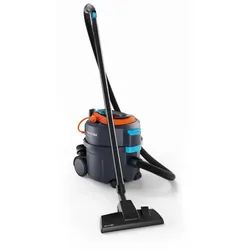
Staubsauger Nilfisk VP300 HEPA EC EU Einfachheit neu definiert, Einfachheit auf Knopfdruckverbesserte Kabelaufbewahrung sorgt für Ordnung Steckplätze für Zubehör intuitive hellblaue Bedienelemente, die selbst für Erst- benutzer eine einfache Bedienung gewährleisten werkzeugloser Zugang zu Beuteln und Filtern für einfachen Beutelwechsel, Ein-/Ausschalter als Fußtaster branchenführende Nettofüllkapazität mit 10 L technische Daten: Leistung: 700 W, Netzkabel: 10 orange Anschluss: 220-240/50-60 V/Hz, Luftmenge: 32 l/sek. Unterdruck: 220 mbar, Lautstärke: 56 dB(A), Filter: HEPA 13 Lieferumfang: 1x Pinseldüse, 1x Vliesfilterbeutel 1x konische Düse, 1x Alu-Rohr Ø32x500 mm, 1x Sackfilter 1x Saugschlauch, 1x Kombidüse 280 mm mit Clip, 1x HEPA H13 Wenn nicht -sofort lieferbar- ist die Lieferzeit 5-10 Tage.169,99 €*Versand: 6,95 €Sichere Weiterleitung zum Anbieter
-
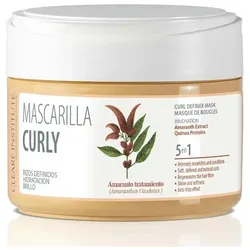
Clearé Institute, Haarmaske, Lockige Haarmaske Nährt und definiert voluminöse Locken 300ml (300 ml)Die Clearé Institute Curly Hair Mask ist eine spezialisierte Behandlung, die entwickelt wurde, um voluminöse Locken zu pflegen und zu definieren und dabei essentielle Feuchtigkeit und Glanz zu spenden. Diese 300 ml Haarmaske richtet sich an Lockentypen, die eine verbesserte Definition und Hydratation benötigen. Die Formel arbeitet daran, die Lockenstruktur zu verbessern, Frizz zu reduzieren und natürliche Lockenmuster zu erhalten, ohne das Haar zu beschweren. Sie enthält feuchtigkeitsspendende Wirkstoffe, die in die Haarschichten eindringen, um die Elastizität wiederherzustellen und Haarbruch zu verhindern. Geeignet für verschiedene Lockentexturen von wellig bis kraus, hilft diese Maske, die Lockenintegrität zwischen den Haarwäschen zu bewahren. Die Anwendung erfolgt auf sauberem, feuchtem Haar mit Fokus auf die mittleren Längen bis zu den Spitzen, Einwirkzeit 3-5 Minuten vor gründlichem Ausspülen. Das Produkt kommt in einem praktischen 300 ml Behälter mit sicherem Verschluss für einfache Lagerung und Nutzung. Clearé Institute konzentriert sich auf Haarpflegelösungen, die durch Forschung zu verschiedenen Haartypen und deren spezifischen Bedürfnissen entwickelt wurden. Diese Maske ist Teil ihrer Lockenpflegeserie, die die besonderen Anforderungen von strukturiertem Haar adressiert. Regelmässige Anwendung trägt zu pflegeleichten, definierten Locken mit reduzierter Trockenheit und verbesserter allgemeiner Haargesundheit bei. Die Formulierung ist darauf ausgelegt, andere Lockenpflegeprodukte zu ergänzen und gleichzeitig intensive Behandlungseffekte zu bieten. Die Verpackung gewährleistet Produktschutz und kontrollierte Dosierung zur Minimierung von Verschwendung. Haarexperten empfehlen diese Art von Behandlung zur Erhaltung von Lockengesundheit und -erscheinung unter verschiedenen Klimabedingungen.28,62 €*Versand: 3,00 €Sichere Weiterleitung zum Anbieter
-
Die Qumran-Essener-Hypothese, Fachbücher von Roland BergmeierDas Buch "Die Qumran-Essener-Hypothese" von Roland Bergmeier bietet eine umfassende Analyse der Hypothese, dass die Essener sowohl die Bewohner der Qumrananlage als auch die ursprünglichen Besitzer der Schriftrollen vom Toten Meer waren. Diese Hypothese, die von Historikern wie Philo, Josephus und Plinius diskutiert wurde, wird in der aktuellen Forschung zunehmend hinterfragt. Bergmeier untersucht die archäologischen Befunde der Qumrananlage sowie die Schriftrollen und deren historische Kontexte. Durch eine kritische Neubewertung der bestehenden Literatur und der archäologischen Daten leistet das Buch einen wertvollen Beitrag zur Josephus-Forschung und zur Diskussion über die Essener. Es richtet sich an Wissenschaftler, Studierende und Interessierte der Geisteswissenschaften, insbesondere im Bereich Religion und Theologie.55,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Datenanalyse mit SPSS, Fachbücher von Michael StreichDieses Buch richtet sich an Studentinnen und Studenten, die im Rahmen ihrer Seminar-, Bachelor- oder Masterarbeit quantitative Daten erheben. Neben deskriptiven Analysen sind in solchen Situationen zumeist induktive statistische Verfahren gefordert, die auf den ersten Blick teilweise relativ komplex erscheinen. In diesem Buch werden typische Verfahren eingeordnet und inhaltlich erläutert. Neben einer einfachen Einführung werden im Nachgang vertiefende Analysen vorgestellt. Alle Verfahren werden anhand von Beispielen auf Basis der Statistiksoftware IBM SPSS dargestellt, die einen sehr einfachen Zugang auch zu komplexeren Verfahren bietet. Dabei werden die Beispiele, nach einer Einführung in das Programm als solches, systematisch Schritt für Schritt bearbeitet, so dass auch eigene Analysen im Rahmen schriftlicher Arbeiten problemlos nachvollzogen werden können.39,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wann Korrelation und wann Regression?
Wann Korrelation und wann Regression? Korrelation wird verwendet, um den Grad des Zusammenhangs zwischen zwei Variablen zu messen, ohne eine Ursache-Wirkungs-Beziehung zu postulieren. Wenn man herausfinden möchte, ob und wie stark zwei Variablen miteinander zusammenhängen, ist die Korrelation die geeignete Methode. Regression hingegen wird verwendet, um eine Vorhersage oder Schätzung einer abhängigen Variablen basierend auf einer oder mehreren unabhängigen Variablen zu machen. Wenn man also den Einfluss einer oder mehrerer Variablen auf eine andere Variable untersuchen möchte, ist die Regression die passende Methode. Insgesamt kann man sagen, dass Korrelation verwendet wird, um den Zusammenhang zwischen Variablen zu untersuchen, während Regression verwendet wird, um Vorhersagen oder Schätzungen basierend auf diesen Zusammenhängen zu machen. Beide Methoden sind wichtige Werkzeuge in der statistischen Analyse, jedoch mit unterschiedlichen Anwendungsgebieten und Zielen. **
-
In welchen Bereichen der Psychologie, Soziologie und Statistik wird der Begriff "Signifikanz" verwendet und wie wird er definiert?
In der Psychologie wird der Begriff "Signifikanz" verwendet, um zu beurteilen, ob die Ergebnisse einer Studie aufgrund von Zufall oder tatsächlichen Effekten beruhen. In der Soziologie wird Signifikanz verwendet, um zu bestimmen, ob die Beziehungen zwischen Variablen in einer Studie statistisch bedeutsam sind. In der Statistik wird Signifikanz verwendet, um festzustellen, ob ein beobachteter Effekt größer ist als das, was aufgrund von Zufall zu erwarten wäre. Signifikanz wird definiert als die Wahrscheinlichkeit, dass ein beobachteter Effekt auf Zufall beruht, und wird in der Regel durch einen p-Wert ausgedrückt. **
-
Was ist die Bedeutung und Anwendung von Korrelation in Statistik und Datenanalyse?
Die Korrelation misst den Zusammenhang zwischen zwei Variablen und zeigt, ob sie gemeinsam variieren. Sie wird verwendet, um Beziehungen zwischen Daten zu identifizieren und Muster zu erkennen. Korrelationen können positiv, negativ oder neutral sein und helfen bei der Interpretation von statistischen Ergebnissen. **
-
Was ist die Bedeutung und Anwendung von Korrelation in der Statistik und Datenanalyse?
Die Korrelation misst den Zusammenhang zwischen zwei Variablen und gibt an, wie stark sie miteinander in Beziehung stehen. In der Statistik wird die Korrelation verwendet, um zu untersuchen, ob es einen linearen Zusammenhang zwischen Variablen gibt. Sie wird auch genutzt, um Vorhersagen zu treffen und Muster in den Daten zu identifizieren. **
Ähnliche Suchbegriffe für Definiert
-
Angstlust und Regression, Fachbücher von Michael BalintAusgehend von Erlebnisqualitäten, die im Englischen mit "Thrill" bezeichnet werden, beschreibt Michael Balint zwei unterschiedliche Verhaltensweisen gegenüber der Welt: die "oknophile" und die "philobatische". Diese Unterscheidung hat zu interessanten Schlussfolgerungen im diagnostischen und therapeutischen Bereich geführt, im Blick auf die Objektbeziehungen, den Umgang mit Angst und Aggressivität, die Autoerotik, Liebe und Hass sowie die Fähigkeit zur Realitätsprüfung. Michael Balint, der durch seine Untersuchungen über die Arzt-Patient-Beziehung weithin bekannt geworden ist, legt hier eine neue psychologische Typenlehre vor. Er unterscheidet zwei Hauptverhaltensweisen gegenüber der Welt, die oknophile und die philobatische. Die erstere ist dadurch gekennzeichnet, dass der Mensch sich an seine Liebesobjekte anklammert und in dieser Anklammerung Schutz und Wonne des Gehaltenseins sucht.25,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist eine Zufallsvariable und wie wird sie in der Wahrscheinlichkeitstheorie definiert?
Eine Zufallsvariable ist eine mathematische Funktion, die jedem möglichen Ergebnis eines Zufallsexperiments eine reelle Zahl zuordnet. In der Wahrscheinlichkeitstheorie wird sie als eine Funktion definiert, die jedem Element des Ereignisraums eines Zufallsexperiments eine reelle Zahl zuordnet. Sie ermöglicht es, Wahrscheinlichkeiten für verschiedene Ereignisse zu berechnen und statistische Analysen durchzuführen. **
-
Was ist der Unterschied zwischen Korrelation und Regression?
Was ist der Unterschied zwischen Korrelation und Regression? Korrelation misst lediglich die Stärke und Richtung des Zusammenhangs zwischen zwei Variablen, während Regression versucht, eine mathematische Beziehung zwischen den Variablen zu modellieren. Korrelation gibt keinen Hinweis auf Ursache und Wirkung, während Regression manchmal verwendet wird, um Vorhersagen zu treffen. Korrelation wird oft mit dem Korrelationskoeffizienten gemessen, während Regression die Beziehung durch eine Regressionsgleichung beschreibt. Insgesamt kann man sagen, dass Korrelation den Zusammenhang zwischen Variablen beschreibt, während Regression versucht, diesen Zusammenhang zu modellieren und zu erklären. **
-
Wie wird die Wahrscheinlichkeitsdichte einer Zufallsvariable definiert und was sind ihre grundlegenden Eigenschaften?
Die Wahrscheinlichkeitsdichte einer Zufallsvariable wird als Funktion definiert, die die Wahrscheinlichkeit angibt, dass die Zufallsvariable einen bestimmten Wert annimmt. Sie muss nicht-negativ sein und die Fläche unter der Kurve muss 1 betragen. Die Wahrscheinlichkeitsdichte kann genutzt werden, um Wahrscheinlichkeiten von Ereignissen zu berechnen. **
-
Wie wird eine Zufallsvariable definiert und wie wird sie in der Wahrscheinlichkeitstheorie verwendet?
Eine Zufallsvariable ist eine mathematische Funktion, die jedem möglichen Ergebnis eines Zufallsexperiments einen numerischen Wert zuordnet. Sie wird in der Wahrscheinlichkeitstheorie verwendet, um die Wahrscheinlichkeiten verschiedener Ereignisse zu berechnen und statistische Analysen durchzuführen. Zufallsvariablen können diskret oder kontinuierlich sein und dienen als Grundlage für die Modellierung von Zufallsprozessen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.